1. Commencer par l’usage, pas par la base de données
La première erreur consiste à lancer un chantier de données sans savoir quel usage IA doit réellement en sortir. Un assistant interne, un moteur de recommandation, une détection d’anomalies ou un modèle de prévision n’exigent pas les mêmes données, ni le même niveau de rigueur. La CNIL rappelle d’ailleurs que ses fiches IA portent sur la constitution et l’utilisation de bases de données lorsqu’elles contiennent des données personnelles, et que les principes RGPD restent le socle de départ.
Le bon réflexe est simple: définir le cas d’usage, le résultat attendu, les décisions qui seront aidées par l’IA, puis les catégories de données réellement nécessaires. Le cadre de gestion des risques du NIST insiste sur une approche par fonction et par cycle de vie, avec gouvernance, cartographie, mesure et traitement des risques. Autrement dit, on ne prépare pas des données pour « faire de l’IA » en général; on les prépare pour un système précis, dans un contexte précis.
Décision pratique: si l’usage n’est pas suffisamment clair pour expliquer quelles données sont indispensables, le chantier est trop tôt. Mieux vaut réduire le périmètre que construire une usine à gaz qui apprendra surtout à coûter cher.
- Formulez le cas d’usage en une phrase métier.
- Listez les décisions que l’IA influencera.
- Identifiez les données minimales nécessaires.
- Excluez tout ce qui n’a pas d’utilité démontrable.
2. Qualité, couverture et biais: trois contrôles non négociables
Préparer les données, ce n’est pas seulement les « nettoyer ». C’est vérifier qu’elles sont suffisamment exactes, complètes, cohérentes, récentes et représentatives de la réalité que l’entreprise veut modéliser. Le règlement européen sur l’IA prévoit, pour les systèmes à haut risque, des pratiques de gouvernance et de gestion des données adaptées à l’usage prévu; la logique est utile bien au-delà des cas strictement réglementés.
Premier contrôle: la qualité. Quelles colonnes sont vides? Quelles valeurs sont impossibles? Quels doublons faussent les volumes? Quel est le taux d’erreurs par source? Deuxième contrôle: la couverture. Les données reflètent-elles toutes les populations, sites, périodes ou produits pertinents, ou seulement la moitié la plus visible de l’activité? Troisième contrôle: le biais. Un historique « propre » peut tout de même être biaisé si les décisions passées étaient elles-mêmes inégales ou incomplètes. Le NIST recommande d’intégrer la mesure et la documentation des risques et du contexte d’usage; cela vaut aussi pour les biais de données.
Pour une PME, l’objectif n’est pas d’atteindre la perfection académique. C’est de savoir si une donnée est assez fiable pour supporter une décision métier. Si elle n’est pas fiable, il faut choisir entre la corriger, la pondérer, la compléter ou l’exclure. Le plus mauvais compromis est de l’engloutir en espérant que le modèle la rendra miraculeusement sage.
- Mesurez les valeurs manquantes, doublons et incohérences.
- Comparez les distributions entre sources, sites et périodes.
- Cherchez les biais de collecte et les biais historiques.
- Documentez ce qui est corrigé, ignoré ou conservé.
3. Droits, base légale et minimisation: le tri qui évite les ennuis
Dès qu’il y a des données personnelles, la préparation des données pour l’IA devient aussi un sujet de conformité. La CNIL rappelle qu’il faut tenir compte de la protection des données dès la collecte et la gestion des données d’apprentissage, avec une attention particulière à la finalité, à la minimisation et à l’encadrement des réutilisations.
Concrètement, une entreprise doit se poser quatre questions: a-t-elle le droit d’utiliser cette donnée pour cet usage précis? la donnée est-elle vraiment nécessaire? le champ contient-il des données sensibles, indirectement sensibles ou trop granulaires? l’information donnée aux personnes et les contrats avec les sous-traitants couvrent-ils cet usage? La réponse « on a déjà la donnée » ne vaut pas base légale. C’est un classique du genre: techniquement possible, juridiquement fragile, commercialement maladroit.
Le cadre européen ajoute une logique de gouvernance des jeux d’entraînement, de validation et de test, notamment pour les systèmes à haut risque. Même quand l’entreprise n’entre pas dans ce périmètre, cette discipline reste rentable: elle réduit les reprises, les litiges, les blocages internes et les mauvaises surprises lors d’un audit client.
- Vérifiez la finalité d’usage, pas seulement la possession de la donnée.
- Minimisez les attributs avant l’entraînement.
- Identifiez les données sensibles et quasi sensibles.
- Tracez les droits, durées de conservation et sous-traitants.
4. Traçabilité, sécurité et annotation: transformer le chaos en actif exploitable
Une donnée utile à l’IA n’est pas seulement juste; elle doit être traçable. Il faut savoir d’où elle vient, quand elle a été collectée, qui l’a modifiée, selon quelles règles et avec quelle version. Sans cette chaîne de provenance, il devient presque impossible d’expliquer une dérive du modèle, de reproduire un résultat ou de répondre à une demande interne de contrôle. Le NIST place d’ailleurs la documentation, la validation et l’interprétation dans le cœur de la gestion des risques.
La sécurité compte autant que la qualité. Données d’apprentissage, étiquettes, scripts de préparation, jeux de test et historiques d’annotations doivent être protégés contre les accès non autorisés, les modifications silencieuses et les fuites. La CNIL met explicitement en avant les impératifs de sécurité dans ses travaux récents sur le développement des systèmes d’IA.
L’annotation mérite, elle aussi, une méthode. Qui annote? avec quelle grille? quel taux de désaccord entre annotateurs? quelle procédure pour trancher les cas ambigus? Un jeu d’étiquettes mal défini produit un modèle très confiant et très faux, ce qui est une combinaison particulièrement coûteuse.
- Versionnez sources, transformations et jeux de données.
- Sécurisez l’accès aux données et aux labels.
- Définissez une grille d’annotation stable.
- Testez la reproductibilité sur un sous-ensemble.
5. Un cadre de décision simple pour une PME
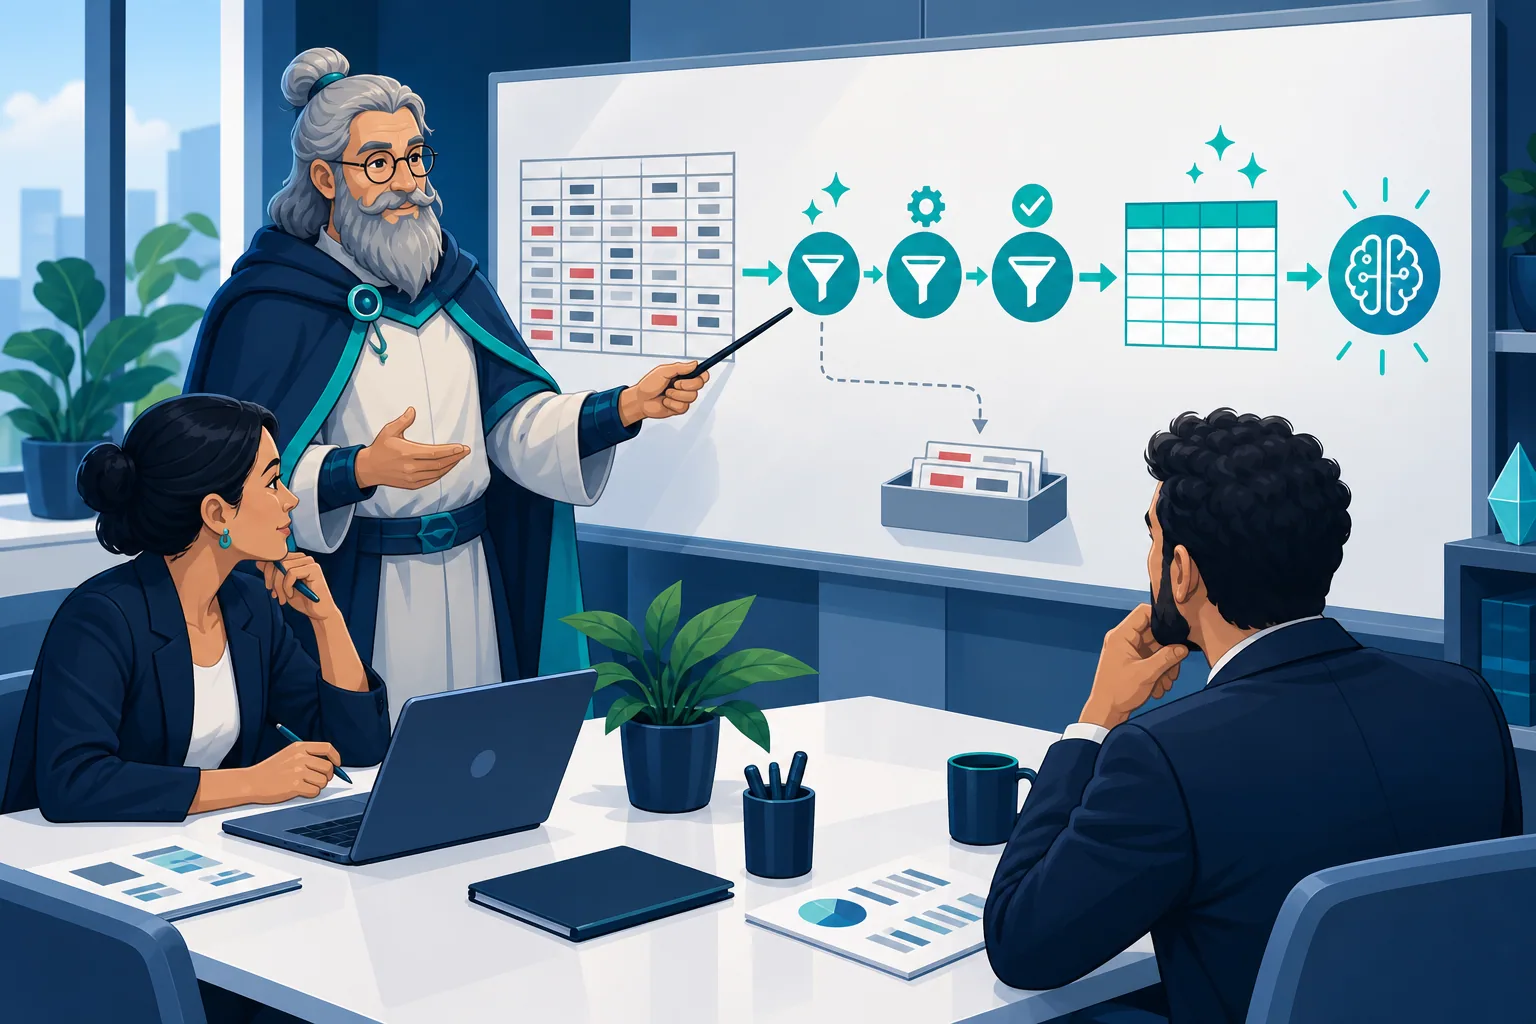
Pour arbitrer rapidement, utilisez une matrice en quatre questions. 1) La donnée est-elle utile au cas d’usage? 2) Est-elle licite et proportionnée? 3) Est-elle assez fiable et représentative? 4) Est-elle traçable et sécurisée? Si la réponse est non à l’une de ces questions, la donnée ne doit pas entrer telle quelle dans le pipeline IA.
Ensuite, classez les données en trois catégories: prêtes, à corriger, à exclure. Les données prêtes vont directement au projet; les données à corriger exigent une action de qualité, de gouvernance ou de conformité; les données à exclure ne devraient pas servir, même si elles sont tentantes parce qu’elles existent déjà. Ce tri évite les programmes qui veulent tout utiliser et finissent par n’exploiter proprement rien du tout.
Implication business: une bonne préparation des données réduit les délais de mise en production, les coûts de réentraînement et le risque de surprise réglementaire. Elle améliore aussi la confiance des métiers, qui acceptent plus volontiers une IA quand les données sources sont compréhensibles, contrôlées et auditables. En IA, la vélocité ne vient pas du désordre bien emballé; elle vient d’une base de données qui sait pourquoi elle existe.
- Prêtes: exploitables sans correction majeure.
- À corriger: utiles, mais encore imparfaites.
- À exclure: trop risquées, trop floues ou trop coûteuses à fiabiliser.
- Révisez cette classification à chaque changement de périmètre.